GeForce RTX 5090×2はどこまで速くなる?1GPU vs 2GPU AI生成ベンチマーク
 gdep
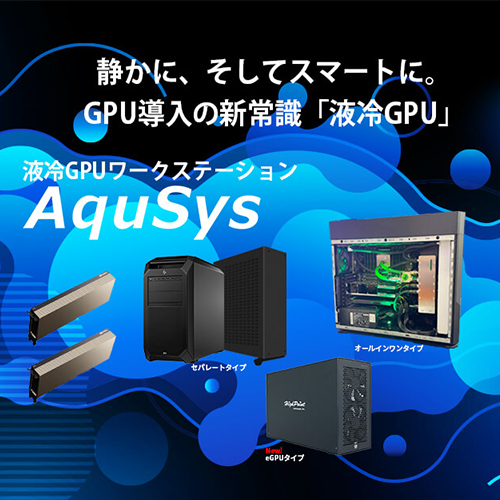
今回、合同会社MetAI様にご協力いただき、GDEPソリューションズの液冷GPUワークステーション「AquSys」にNVIDIA® GeForce RTX™ 5090を2基搭載し、Raylightを用いて使用GPU数を1基・2基に切り替え、画像生成・画像編集・動画生成などの処理時間を比較しました。
本記事では、主要な検証条件とベンチマーク結果を中心に、デュアルGPU構成による処理速度やGPUメモリ活用の効果をご紹介します。
1GPU構成と2GPU構成のベンチマーク結果
[2GPUによる高速化]
約6.94倍
画像編集タスク
1GPU:38.11秒
→ 2GPU:5.49秒
[2GPUによる高速化]
約3.10倍
画像+音声の動画生成
1GPU:163.46秒
→ 2GPU:52.75秒
[検証条件]
400W
各GPUの電力上限
電力制限下で
ベンチマークを実施
1. ベンチマーク結果 サマリー
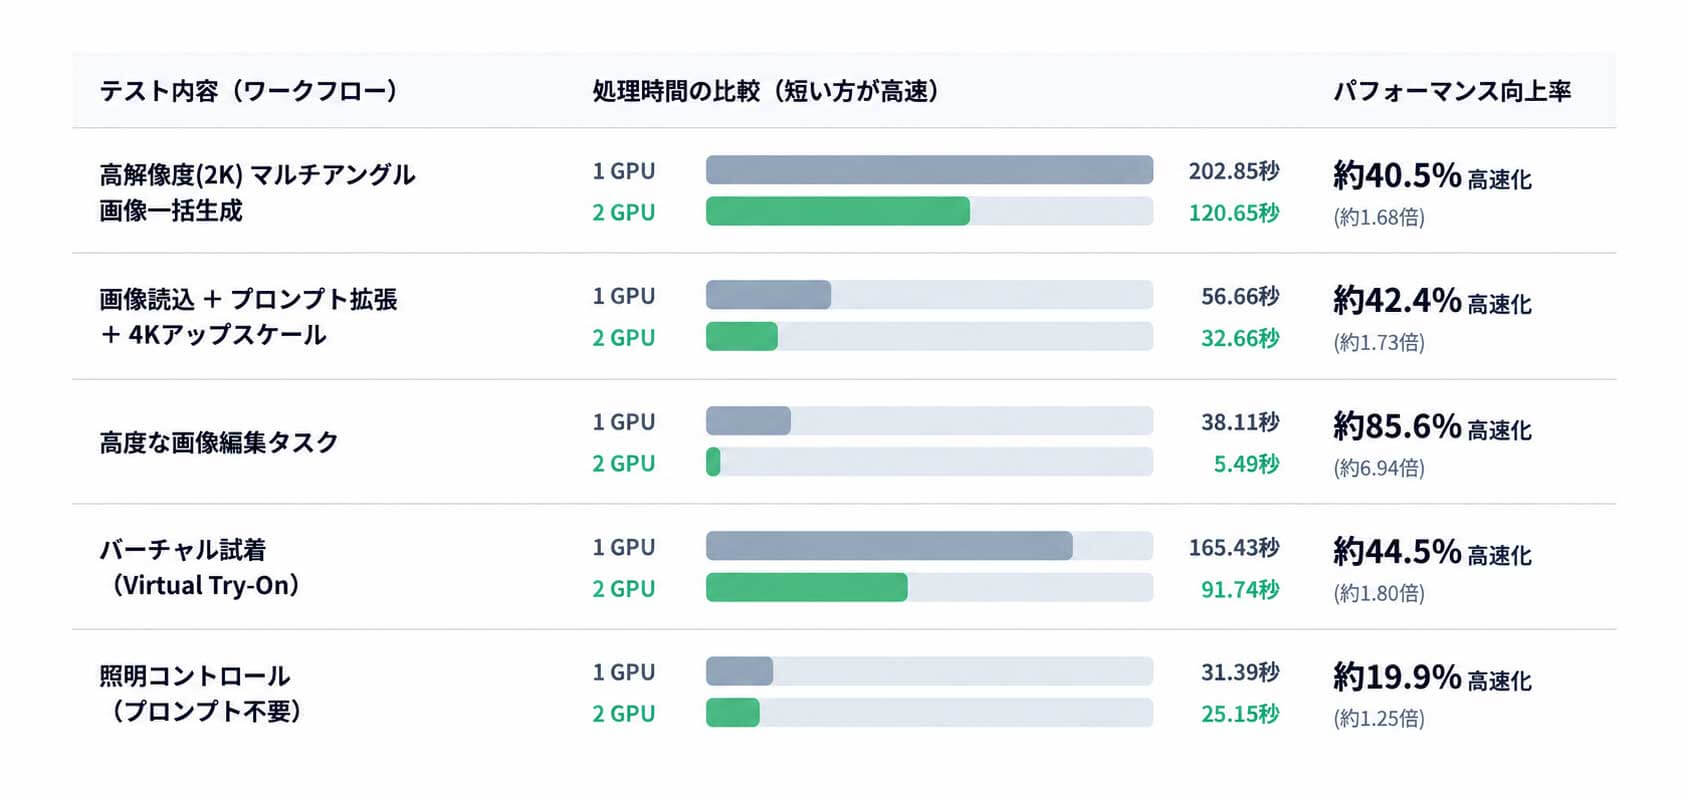
画像生成・編集では5種類、動画生成・編集では5種類のワークフローを比較しました。
すべてのテストで2GPU構成の処理時間が短縮されています。
画像生成タスクの処理時間比較
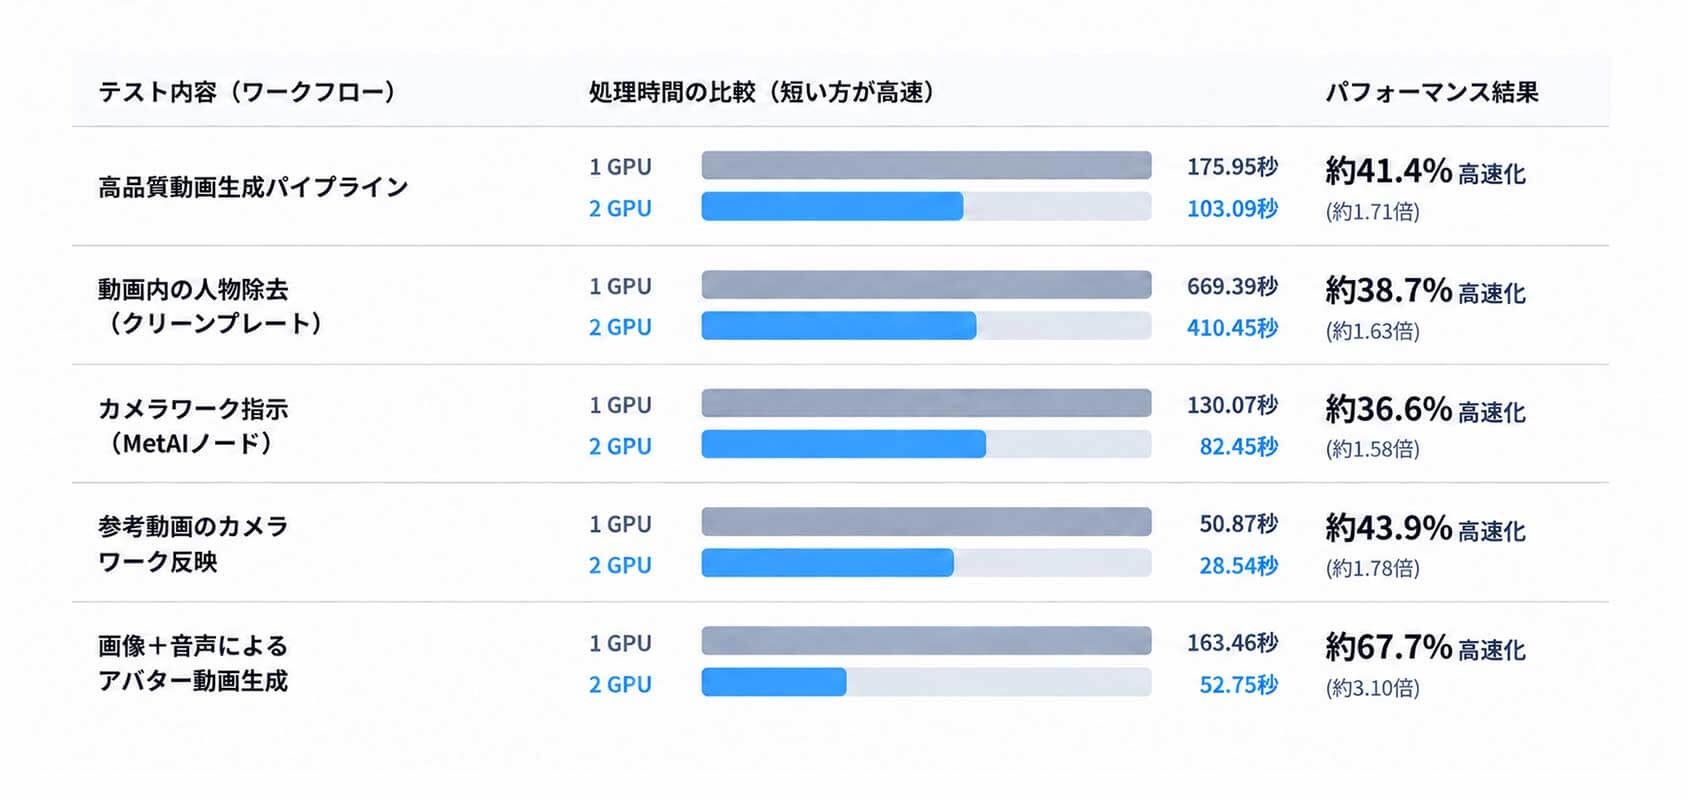
動画生成タスクの処理時間比較
2. テスト環境と電力設定
強力なGPUを2基稼働させる際、通常のオフィスや自宅環境では電力消費が懸念されます。
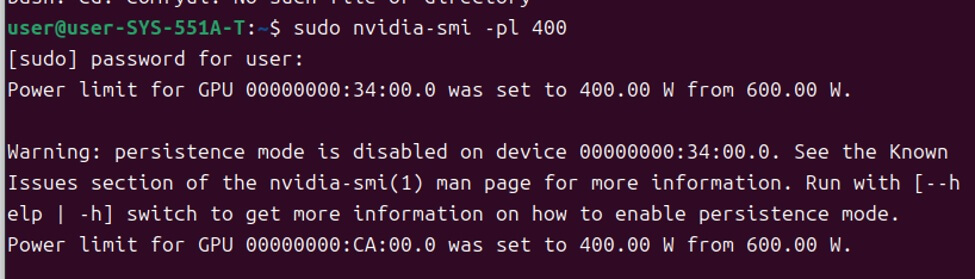
RTX 5090の最大Power Limitは600W(リファレンスTGP 575Wを上回る)となり、今回のテストでは各GPUの電力上限を400Wに設定しました。
画像生成、動画生成、および音声連動動画といった高い計算負荷と GPUメモリ使用量を伴う生成AIタスクを用いて、1基のGPU(シングル)環境と2基のGPU(デュアル)環境のパフォーマンスを比較しました。

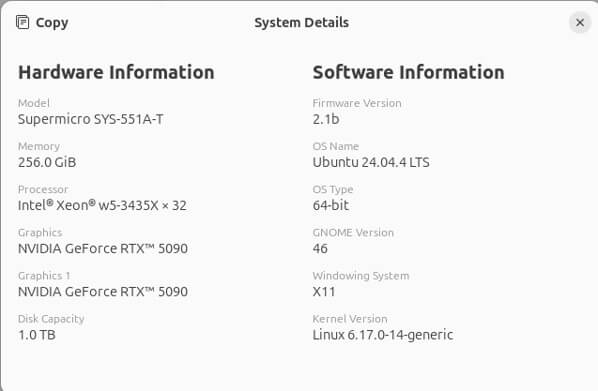
GeForce RTX 5090 ×2 搭載モデル
< システム構成 >
確認結果
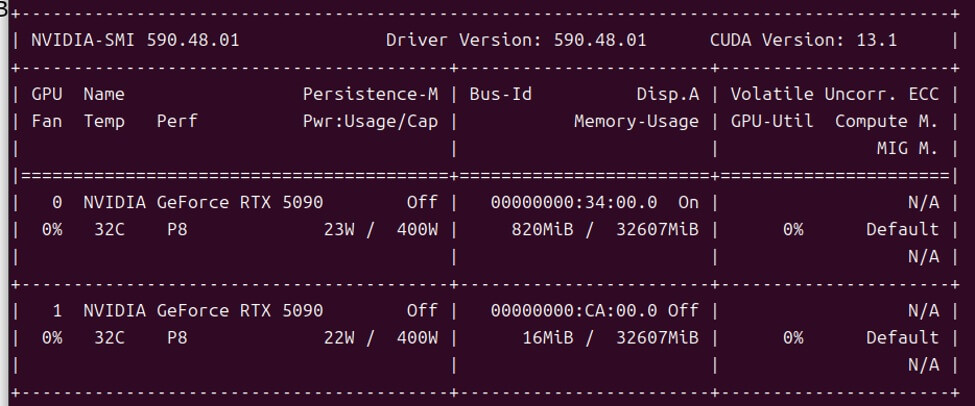
この設定により、待機時は約22W〜23W、稼働時でも上限400Wに制限した状態で、高負荷なAI生成を安定して実行できることを確認しました。
▶ 電力設定と確認画面を見る
電力制限(400W)の適用:
sudo nvidia-smi -pl 400
電力消費の確認方法:
待機時およびAI生成時にGPUがどの程度の電力を消費するかを確認するため、以下のコマンドを使用しました。
nvidia-smi
待機時
AI生成時
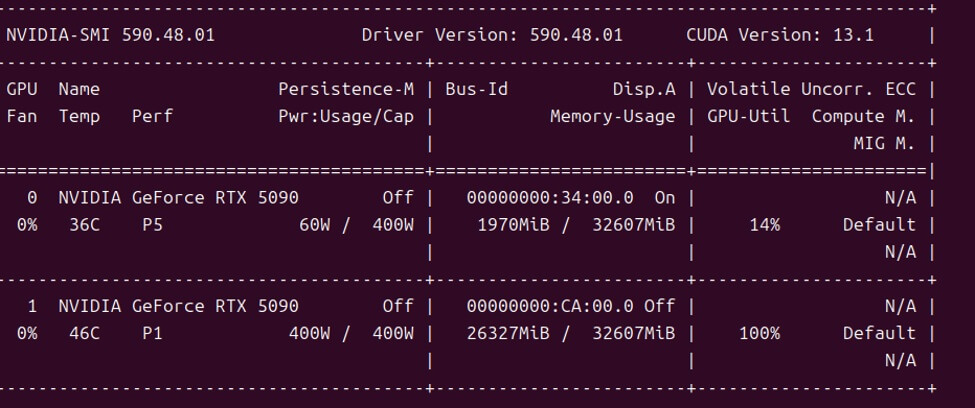
3. デュアルGPUの処理を加速する「Raylight」
複数GPUを搭載していても、1つのAIタスクが1つのGPUにしか割り当てられない場合、もう1基のGPUを十分に活用できません。
Raylightを使用することにより、複雑なAIモデルの計算処理やVRAM負荷を2基のGPUに分散させることができます。
これにより、単一GPUのVRAM(32GB)では収まらない処理にも対応することができました。
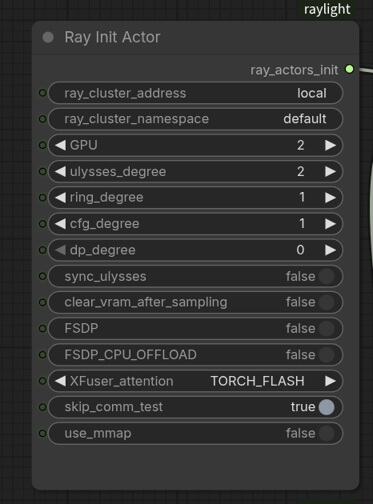
なぜ「ComfyUI-Distributed」ではなく「Raylight」を採用したのか
ComfyUI-Distributedは、1つの重い処理を2基のGPUに分割して並列実行するのではなく、ワークフロー内の異なるタスク(またはセクション)を各GPUに振り分ける仕組みです。
そのため、今回検証したかったデュアルGPU構成の性能を十分に引き出すという目的には適していないと判断し、Raylightを採用しました。
ComfyUI-Distributed
(タスク並列化 / タスクの振り分け)
異なる作業を別々のGPUに割り振ります。複数の画像を同時に生成する用途には向いていますが、各GPUは自身のVRAM(32GB)内で独立して動作します。そのため、1つのGPUのVRAM容量を超える処理では、メモリ不足(OOM)が発生します。
Raylight
(テンソル並列化 / モデル分割による並列処理)
今回のテストで採用した手法です。1つの重い生成処理を、モデルと計算処理ごとに2基のRTX 5090に分割し、同期しながら並列に実行します。各GPUが保持するVRAM量が減るため、単一GPUのVRAM(32GB)では収まらない処理も実行できるようになります。
※ 高度な画像編集タスクでは、モデルが単一GPUのVRAM(32GB)に収まらず、1GPU構成ではCPU/システムメモリへのオフロードが発生していました。
約6.94倍の差の大半は、Raylightがモデルを2基のGPUに分散(FSDP)してオフロードを解消したことによるものです。
4. ローカル環境ならではのメリット
- クラウド環境の課題
- 多くのマネージド/サーバーレス型AIサービスでは、 コールドスタートやジョブ単位のリソース割り当てが発生し、生成のたびに待機時間が加わる場合があります。
- ローカル環境のメリット
- ローカル環境では、初回生成時(コールドスタート)に AIモデルをGPUの高速なメモリ(VRAM)に読み込みます。
- 2回目以降はモデルの読み込みをスキップ
- モデルがVRAM上に保持されているため、 2回目以降はモデルの読み込みプロセスをスキップし、 プロンプトの計算など必要な処理に集中できます。
検証結果
2回目以降の生成スピードは、初回と比較して 最大約60%高速化されました。
▶ 使用ソフトウェア/バージョン
- ComfyUI 0.28
- Raylight 1.6.0

5. ベンチマーク結果(1GPU vs 2GPU)
画像テスト
静止画の生成、編集、アップスケーリングにおける比較です。
① 高解像度(2K) マルチアングル画像一括生成
1つの画像をもとに、元のシーン設定を維持しながら複数アングルを生成します。短時間で複数アングルを生成できるため、絵コンテ作成などに活用できます。
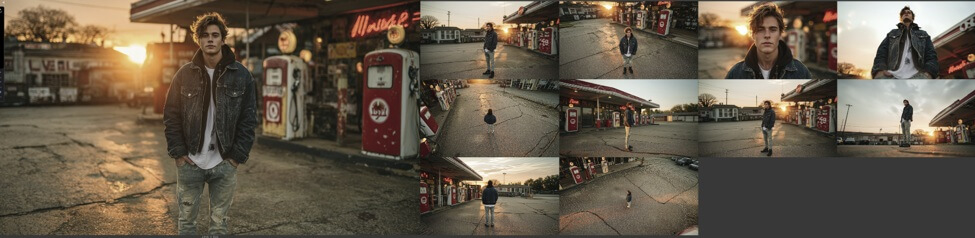
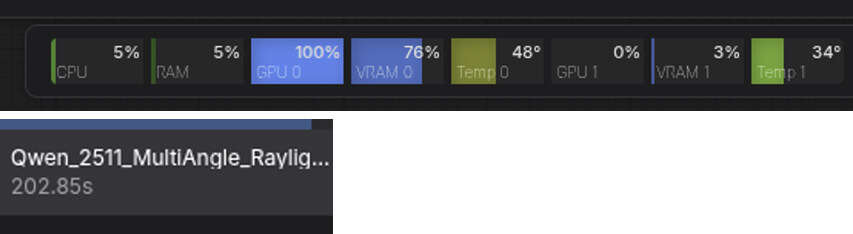
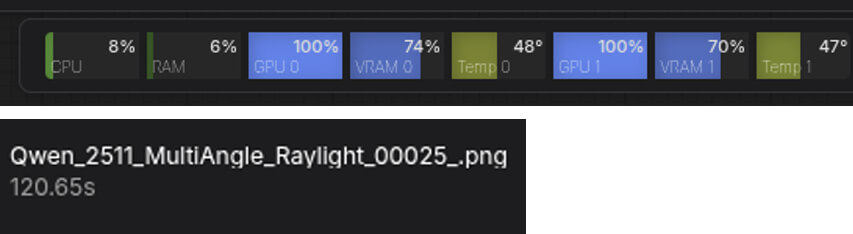
202.85秒 → 120.65秒(約1.68倍)
▶ 処理時間・リソース使用率の比較結果を見る
■ 処理時間の比較
| 1GPU | 2GPU | |
|---|---|---|
| 処理時間 | 202.85秒 | 120.65秒 |
| 処理時間短縮率 | — | 約40.5% 高速化 |
| 処理速度倍率 | 1.00倍 | 約1.68倍 |
■ リソース使用率の比較
| 項目 | 1GPU | 2GPU |
|---|---|---|
| CPU | 5% | 8% |
| RAM | 5% | 6% |
| GPU0 | 100% | 100% |
| VRAM0 | 76% | 74% |
| Temp 0 | 48° | 48° |
| GPU1 | 0% | 100% |
| VRAM1 | 3% | 70% |
| Temp 1 | 34° | 47° |
※ 2 GPU 構成では GPU1が 0%→100%、VRAM1が 3%→70% となり、Raylight により2基目のGPUも並列で稼働していることが確認できます。
■ 実測画面(1GPU vs 2GPU)
1GPU
2GPU(Raylight)
▶ 生成設定を見る
- モデル:Krea2 Turbo(FP8)
- テキストエンコーダ(CLIP):Qwen3-VL 4B(FP8)
- VAE:qwen_image_vae
- LoRA:Krea2 KNPV3 / strength 1.00
- 精度:FP8
- サンプラー:ClownsharkKSampler(linear/euler)/ scheduler simple
- ステップ数:8 / CFG:1.0
- 解像度:1344×768 → 2ndパス → SeedVR2で4Kアップスケール(3808×2176)
- 後処理:カラー補正/グレイン/シャープ
② 画像生成 + プロンプト拡張 + 4Kアップスケール
画像生成では、プロンプトの記述や情報が十分でない場合、意図したイメージと異なる画像が生成されることがあります。このワークフローでは、入力したプロンプトを調整・拡張し、生成した画像を4Kまでアップスケールできます。
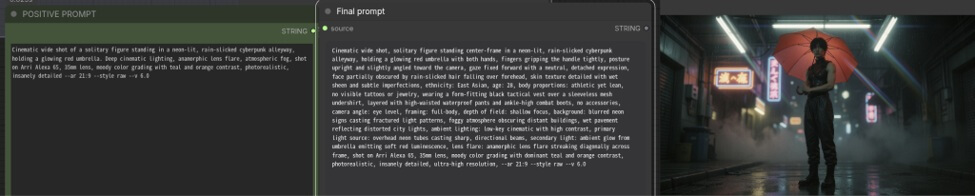
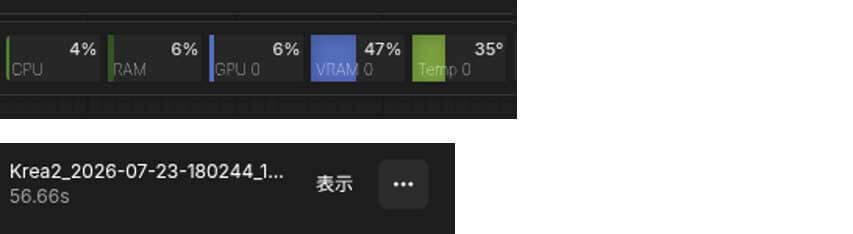
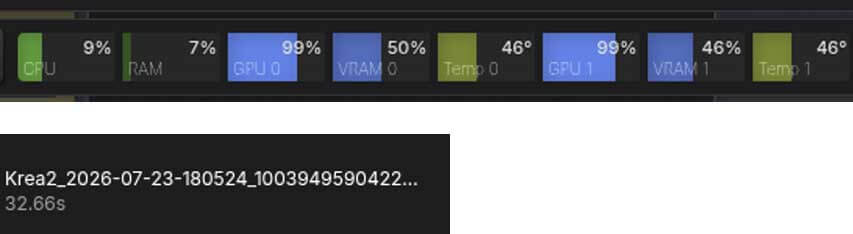
56.66秒 → 32.66秒(約1.73倍)
▶ 処理時間・リソース使用率の比較結果を見る
■ 処理時間の比較
| 1GPU | 2GPU | |
|---|---|---|
| 処理時間 | 56.66秒 | 32.66秒 |
| 処理時間短縮率 | — | 約42.4% 高速化 |
| 処理速度倍率 | 1.00倍 | 約1.73倍 |
■ リソース使用率の比較
| 項目 | 1GPU | 2GPU |
|---|---|---|
| CPU | 4% | 9% |
| RAM | 6% | 7% |
| GPU0 | 6% | 99% |
| VRAM0 | 47% | 50% |
| Temp 0 | 35° | 46° |
| GPU1 | — | 99% |
| VRAM1 | — | 46% |
| Temp 1 | — | 46° |
■ 実測画面(1GPU vs 2GPU)
1GPU
2GPU(Raylight)
▶ 生成設定を見る
- モデル:Krea2 Turbo(FP8)
- テキストエンコーダ(CLIP):Qwen3-VL 4B(FP8)
- VAE:qwen_image_vae
- LoRA:Krea2 KNPV3 / strength 1.00
- 精度:FP8
- サンプラー:ClownsharkKSampler(linear/euler)/ scheduler simple
- ステップ数:8 / CFG:1.0
- 解像度:1344×768 → 2ndパス → SeedVR2で4Kアップスケール(3808×2176)
- 後処理:カラー補正/グレイン/シャープ
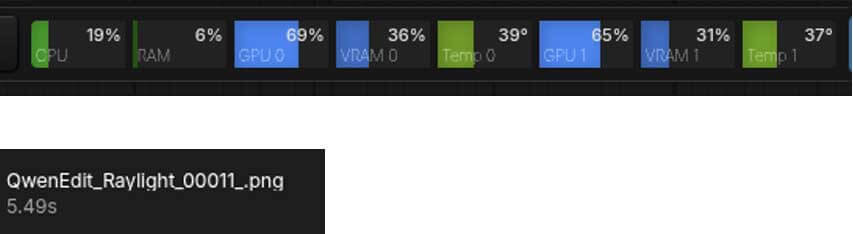
③ 高度な画像編集タスク
こちらのワークフローでは、キャラクターのポーズ・髪型・衣装の変更、背景のカスタマイズ、照明の調整まで行うことができます。
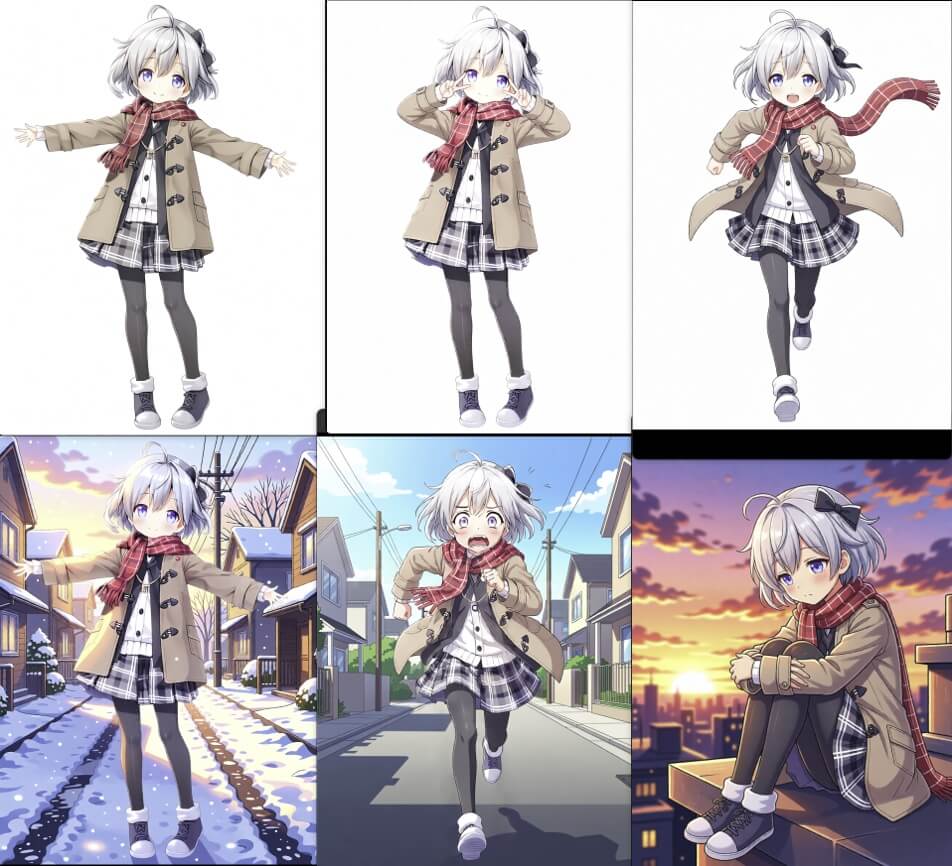
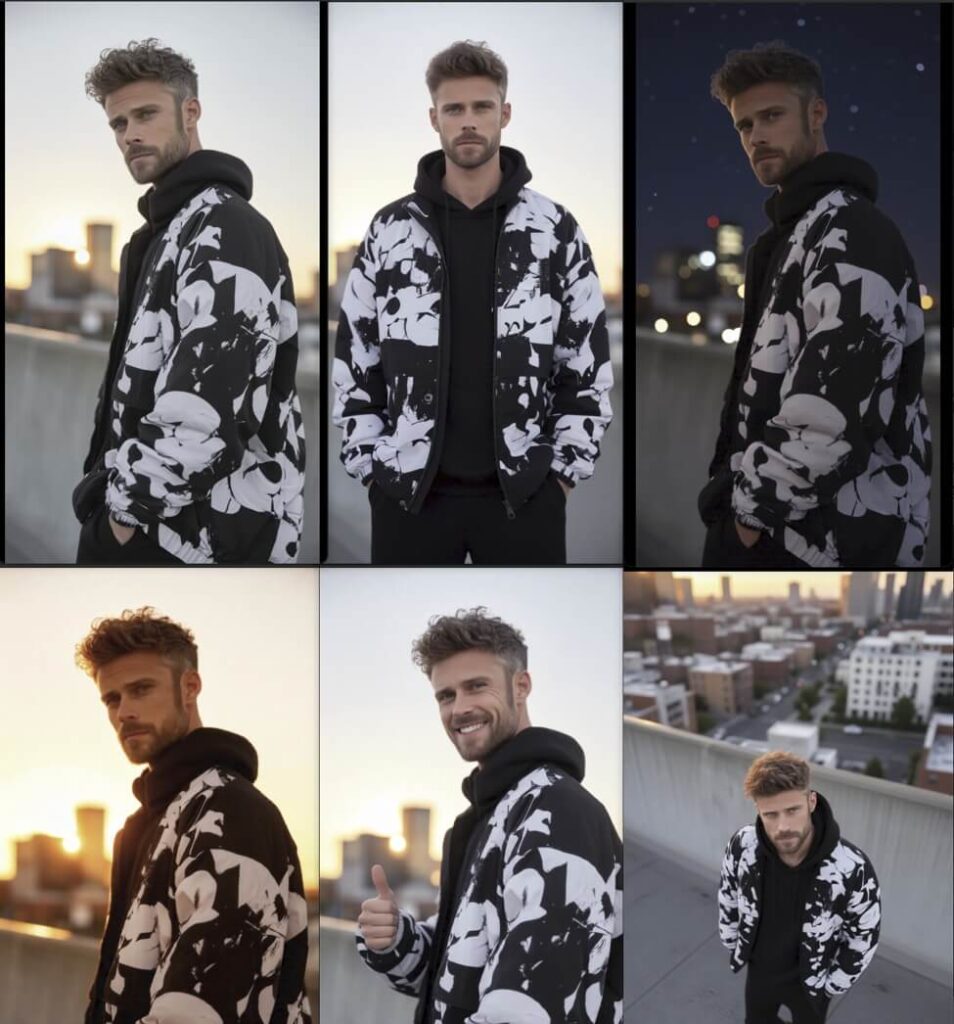
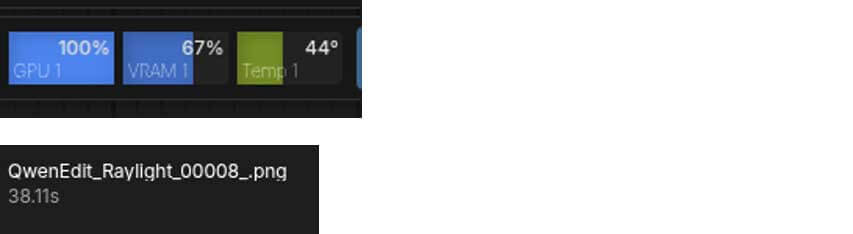
38.11秒 → 5.49秒(約6.94倍)
▶ 処理時間・リソース使用率の比較結果を見る
■ 処理時間の比較
| 1GPU | 2GPU | |
|---|---|---|
| 処理時間 | 38.11秒 | 5.49秒 |
| 処理時間短縮率 | — | 約85.6% 高速化 |
| 処理速度倍率 | 1.00倍 | 約6.94倍 |
■ リソース使用率の比較
| 項目 | 1GPU | 2GPU |
|---|---|---|
| CPU | — | 19% |
| RAM | — | 6% |
| GPU0 | 100% | 69% |
| VRAM0 | 67% | 36% |
| Temp 0 | 44° | 39° |
| GPU1 | — | 65% |
| VRAM1 | — | 31% |
| Temp 1 | 44° | 37° |
■ 実測画面(1GPU vs 2GPU)
1GPU
2GPU(Raylight)
▶ 生成設定を見る
- モデル(UNET):Qwen-Image-Edit-2511(FP8 / e4m3fn)
- テキストエンコーダ(CLIP):Qwen2.5-VL-7B(FP8 scaled)
- VAE:qwen_image_vae
- 高速化LoRA:Qwen-Image-Edit-2511-Lightning-4steps V1.0(bf16)/ strength 1.00
- 精度:FP8(e4m3fn)
- サンプラー:Euler / スケジューラ:simple
- ステップ数:4 ・CFG:1.0 / denoise:1.00
- 解像度:1648 x 2944
④ バーチャル試着(Virtual Try-On)
撮影後に衣装の調整や変更が必要になった場合、通常は再撮影が必要となり、時間やコストがかかります。このワークフローでは、元のキャラクターをベースに衣装を変更できます。キャラクター、トップス、ボトムスの画像を組み合わせて、新しい衣装を着用した画像を生成します。
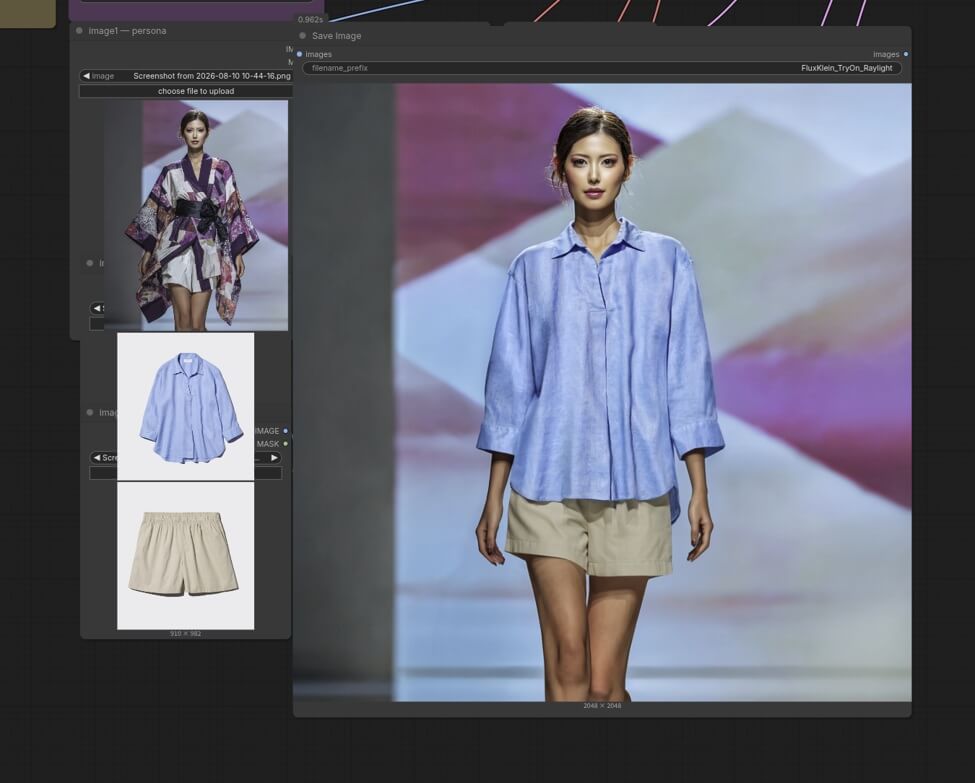
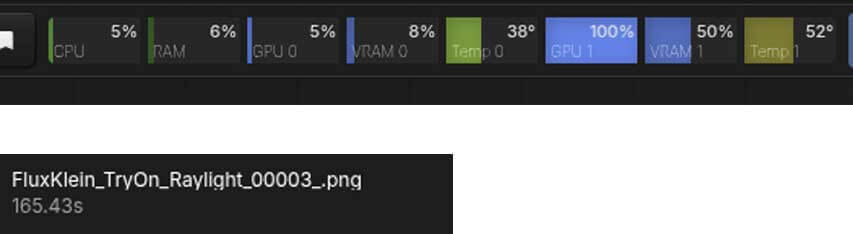
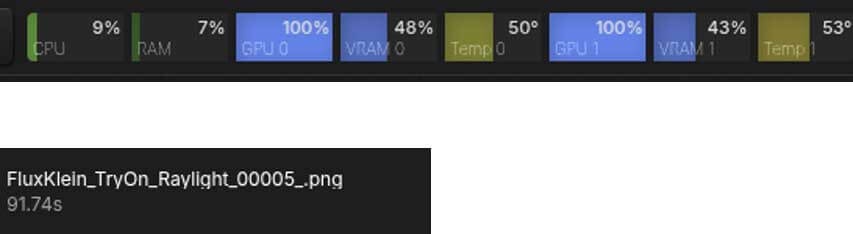
165.43秒 → 91.74秒(約1.80倍)
▶ 処理時間・リソース使用率の比較結果を見る
■ 処理時間の比較
| 1GPU | 2GPU | |
|---|---|---|
| 処理時間 | 165.43秒 | 91.74秒 |
| 処理時間短縮率 | — | 約44.5% 高速化 |
| 処理速度倍率 | 1.00倍 | 約1.80倍 |
■ リソース使用率の比較
| 項目 | 1GPU | 2GPU |
|---|---|---|
| CPU | 5% | 19% |
| RAM | 6% | 7% |
| GPU0 | 5% | 100% |
| VRAM0 | 8% | 48% |
| Temp 0 | 38° | 50° |
| GPU1 | 100% | 100% |
| VRAM1 | 50% | 43% |
| Temp 1 | 52° | 53° |
■ 実測画面(1GPU vs 2GPU)
1GPU
2GPU(Raylight)
▶ 生成設定を見る
- モデル(UNET):Flux 2 Klein base 9B(FP8)
- テキストエンコーダ(CLIP):Qwen3-8B(FP8 mixed)
- VAE:full_encoder_small_decoder
- LoRA:flux-klein-tryon-comfy / strength 1.00
- 精度:FP8
- サンプラー:Euler / スケジューラ:simple
- ステップ数:28
- CFG:3.0 / denoise:1.00
- 解像度:2944 × 816
⑤ 照明コントロール(プロンプト不要)
照明の回転・仰角・強度などをプロンプトで意図どおりに調整するのは容易ではありません。このワークフローでは、プロンプトを使わず、クリック操作で照明を調整できます。
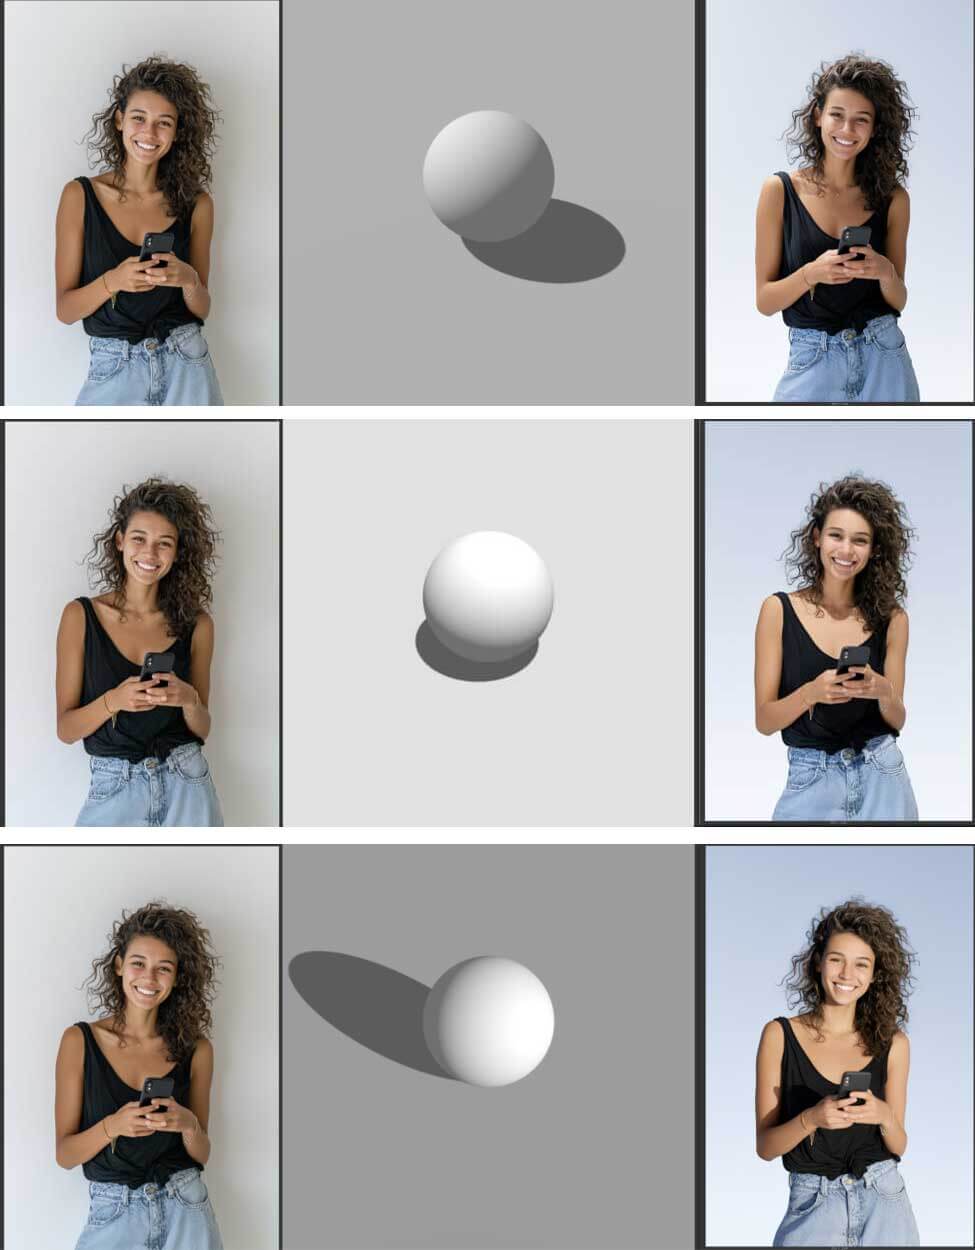
31.39秒 → 25.15秒(約1.25倍)
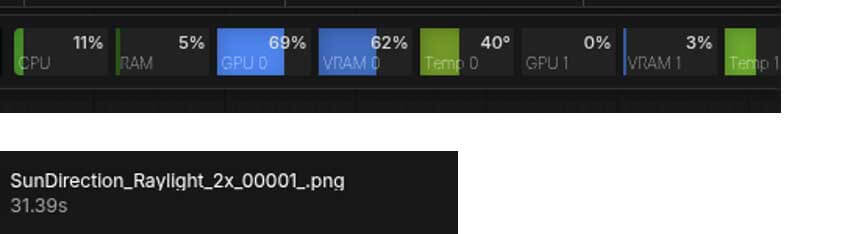
▶ 処理時間・リソース使用率の比較結果を見る
■ 処理時間の比較
| 1GPU | 2GPU | |
|---|---|---|
| 処理時間 | 31.39秒 | 25.15秒 |
| 処理時間短縮率 | — | 約19.9% 高速化 |
| 処理速度倍率 | 1.00倍 | 約1.25倍 |
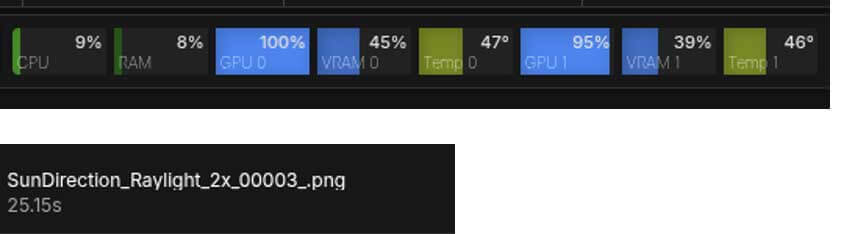
■ リソース使用率の比較
| 項目 | 1GPU | 2GPU |
|---|---|---|
| CPU | 11% | 9% |
| RAM | 5% | 8% |
| GPU0 | 69% | 100% |
| VRAM0 | 62% | 45% |
| Temp 0 | 40° | 47° |
| GPU1 | 0% | 95% |
| VRAM1 | 3% | 39% |
| Temp 1 | — | 46° |
■ 実測画面(1GPU vs 2GPU)
1GPU
2GPU(Raylight)
▶ 生成設定を見る
- モデル(UNET):Flux 2 Klein base 9B(FP8)
- テキストエンコーダ(CLIP):Qwen3-8B(FP8 mixed)
- VAE:flux2-vae
- Sun LoRA:Sun_direction_LoRA_Flux_2_Klein_9b_v1 / strength 1.00
- 精度:FP8
- 解像度:896 x 1344
動画テスト
動画生成・編集でも、2GPU構成による処理時間の短縮を確認しました。
① テキスト→動画生成(HD)
テキストから動画を生成する際は、プロンプトだけでなく、使用するモデルも重要です。今回のワークフローでは、モデル、プロンプト、アップスケールを組み合わせることで、品質を維持しながら高品質な動画を生成できます。
また、クラウド型のAIプラットフォームでは生成できる動画の長さに制限がある場合がありますが、ローカル環境では、クラウドサービス固有の動画長の制限を受けずに生成できます。
175.95秒 → 103.09秒(約1.71倍)
▶ 処理時間・リソース使用率の比較結果を見る
■ 処理時間の比較
| 1GPU | 2GPU | |
|---|---|---|
| 処理時間 | 175.95秒 | 103.09秒 |
| 処理時間短縮率 | — | 約41.4% 高速化 |
| 処理速度倍率 | 1.00倍 | 約1.71倍 |
■ リソース使用率の比較
| 項目 | 1GPU | 2GPU |
|---|---|---|
| CPU | 7% | 10% |
| RAM | 5% | 7% |
| GPU0 | 100% | 100% |
| VRAM0 | 34% | 36% |
| Temp 0 | 49° | 49° |
| GPU1 | 0% | 100% |
| VRAM1 | 3% | 31% |
| Temp 1 | 34° | 53° |
▶ 生成設定を見る
- モデル(UNET):Wan 2.2(wan2.2_fun_camera_high_noise)
- テキストエンコーダ(CLIP):umT5-XXL(FP8 / e4m3fn scaled)
- VAE:Wan2.1 VAE(bf16)
- 高速化LoRA:Wan2.1 T2V 14B lightx2v(4ステップ蒸留)/ strength 1.00
- 精度:FP8(e4m3fn)
- サンプラー:Euler / スケジューラ:simple
- ステップ数:4 / CFG:1.0 / denoise:1.00
- 解像度:1280×720(HD)
- フレーム数:81フレーム / 16fps
- ビット深度:8bit
② 動画内の人物除去
撮影した映像に多くの人物が映り込んでいる場合、一人ひとりにモザイク処理を行うには手間と時間がかかります。このワークフローでは、映像内の人物をまとめて削除し、人物の映り込んでいない映像を生成できます。
669.39秒 → 410.45秒(約1.63倍)
▶ 処理時間・リソース使用率の比較結果を見る
■ 処理時間の比較
| 1GPU | 2GPU | |
|---|---|---|
| 処理時間 | 669.39秒 | 410.45秒 |
| 処理時間短縮率 | — | 約38.7% 高速化 |
| 処理速度倍率 | 1.00倍 | 約1.63倍 |
■ リソース使用率の比較
| 項目 | 1GPU | 2GPU |
|---|---|---|
| CPU | 6% | 10% |
| RAM | 10% | 12% |
| GPU0 | 15% | 95% |
| VRAM0 | 7% | 67% |
| Temp 0 | 35° | 53° |
| GPU1 | 90% | 100% |
| VRAM1 | 75% | 63% |
| Temp 1 | 45° | 53° |
▶ 生成設定を見る
- モデル(UNET):LTX-Video 2.3 22B(distilled / FP8)
- テキストエンコーダ:Gemma 3 12B IT + LTX-2.3 text projection(bf16)
- Video VAE:LTX23_video_vae(bf16)/ Audio VAE:LTX23_audio_vae(bf16)
- クリーンプレートLoRA:ltx-2.3-22b-ic-lora-clean-plate-1.0 / strength 1.00
- 高速化LoRA:ltx-2.3-22b-distilled-1.1(dynamic)/ strength 1.00
- 精度:FP8
- サンプラー:euler_ancestral_cfg_pp / CFG:1.0
- ステップ数:8
- 解像度:1280×720(HD)
- フレーム数:121フレーム / 25fps
③ 1枚の画像から指定したカメラワークの動画を生成
カメラワークを設定するワークフローは数多くありますが、プロンプトで意図したカメラワークを正確に指示するのは難しく、適切なプロンプトを作成するには時間がかかります。
MetAIオリジナルノードを追加することで、ボタンをクリックするだけで、希望するカメラワークを指定できます。
130.07秒 → 82.45秒(約1.58倍)
▶ 処理時間・リソース使用率の比較結果を見る
■ 処理時間の比較
| 1GPU | 2GPU | |
|---|---|---|
| 処理時間 | 130.07秒 | 82.45秒 |
| 処理時間短縮率 | — | 約36.6% 高速化 |
| 処理速度倍率 | 1.00倍 | 約1.58倍 |
■ リソース使用率の比較
| 項目 | 1GPU | 2GPU |
|---|---|---|
| CPU | 7% | 15% |
| RAM | 12% | 14% |
| GPU0 | 7% | 98% |
| VRAM0 | 8% | 46% |
| Temp 0 | 38° | 53° |
| GPU1 | 100% | 97% |
| VRAM1 | 72% | 41% |
| Temp 1 | 51° | 53° |
▶ 生成設定を見る
- モデル(UNET):Wan 2.2 Fun Camera 14B(FP8)
- 高速化LoRA:Wan2.2 i2v lightx2v(4ステップ)
high noise / low noise 各strength 1.00 - カメラ制御:WanCameraImageToVideo + Camera Buttons(MetAI)
- 精度:FP8
- サンプラー:Euler / スケジューラ:simple / CFG:1.0 / shift:8.00
- ステップ数:6(high/low の2サンプラーに分割)
- 解像度:720×720
- フレーム数:81フレーム / 16fps
④ 参考動画のカメラワークを画像に反映
50.87秒 → 28.54秒(約1.78倍)
▶ 処理時間・リソース使用率の比較結果を見る
■ 処理時間の比較
| 1GPU | 2GPU | |
|---|---|---|
| 処理時間 | 50.87秒 | 28.54秒 |
| 処理時間短縮率 | — | 約43.9% 高速化 |
| 処理速度倍率 | 1.00倍 | 約1.78倍 |
■ リソース使用率の比較
| 項目 | 1GPU | 2GPU |
|---|---|---|
| CPU | 6% | 17% |
| RAM | 21% | 8% |
| GPU0 | 4% | 78% |
| VRAM0 | 7% | 84% |
| Temp 0 | 34° | 44° |
| GPU1 | 100% | 78% |
| VRAM1 | 81% | 79% |
| Temp 1 | 46° | 43° |
▶ 生成設定を見る
- モデル(UNET):LTX-Video 2.3 22B(distilled / FP8)
- IC-LoRA:LTX2.3-22B Cameraman v1 / strength 1.00
- テキストエンコーダ:Gemma 3 12B IT + LTX-2.3 text projection(bf16)
- Video VAE:LTX23_video_vae(bf16)/ Audio VAE:LTX23_audio_vae(bf16)
- 最適化:Sage Attention、fp16 accumulation、Chunk FeedForward、
NAG(nag_scale 11.0) - 精度:FP8
- fps:24
- 解像度:960×544
- フレーム数:81フレーム / 24fps ・出力:H.264 MP4(yuv420p / CRF 19)
⑤ 画像+音声によるアバター動画生成
音声データと画像を組み合わせ、口の動きを音声に連動させたアバター動画を生成する複合タスクです。
163.46秒 → 52.75秒(約3.10倍)
▶ 処理時間・リソース使用率の比較結果を見る
■ 処理時間の比較
| 1GPU | 2GPU | |
|---|---|---|
| 処理時間 | 163.46秒 | 52.75秒 |
| 処理時間短縮率 | — | 約67.7% 高速化 |
| 処理速度倍率 | 1.00倍 | 約3.10倍 |
■ リソース使用率の比較
| 項目 | 1GPU | 2GPU |
|---|---|---|
| CPU | 5% | 13% |
| RAM | 5% | 11% |
| GPU0 | 17% | 77% |
| VRAM0 | 6% | 61% |
| Temp 0 | 34° | 45° |
| GPU1 | 100% | 76% |
| VRAM1 | 43% | 57% |
| Temp 1 | 40° | 47° |
▶ 生成設定を見る
- 処理内容:静止画(人物)+音声から、口の動きが同期した歌唱動画を生成
- モデル(UNET):LTX-Video 2.3 22B(distilled / FP8)
- テキストエンコーダ:Gemma 3 12B IT + LTX-2.3 text projection(bf16)
- Video VAE:LTX23_video_vae(bf16)/ Audio VAE:LTX23_audio_vae(bf16)
- 高速化LoRA:ltx-2.3-22b-distilled-lora-dynamic / strength 0.45
- 精度:FP8
- サンプラー:LCM / CFG:1.0
- ステップ数:8(蒸留スケジュール・手動sigmas)
- シード:89361831441044(randomize)
- Img→Video強度:0.7
- 解像度:720×720
- フレーム数:481フレーム / 24fps(約20秒)
- 出力:H.264 MP4(yuv420p / CRF 19)
5. 検証結果まとめ
● デュアルGPUによる処理時間の短縮:
デュアルGPUとRaylightを組み合わせることで、画像編集タスクでは最大約6.9倍、その他の生成タスクでも約1.3倍~3.1倍の処理速度向上を確認しました。画像生成・編集から動画生成まで、さまざまなAIワークフローで2GPU構成の効果を確認できました。
● 400Wの電力制限下でも安定して実行:
今回の検証では、各GPUの電力上限を400Wに設定した状態でベンチマークを実施しました。電力を制限した環境でも、高負荷な画像生成・動画生成タスクを安定して実行できることを確認しました。
● VRAMを多く使用するAIワークフローにも対応:
高度な画像編集タスクでは、1GPU構成ではモデルが32GBのVRAMに収まらず、CPU/システムメモリへのオフロードが発生しました。一方、2GPU構成では、Raylightによってモデルを2基のGPUに分散することでオフロードを解消し、処理時間を38.11秒から5.49秒へ短縮しました。VRAMを多く使用するAIワークフローにおいても、2GPU構成の有効性を確認できました。
※ ベンチマーク結果は、使用モデル・ソフトウェア構成・ワークフローによって変動します。
※ 本記事は、合同会社MetAI様による検証結果をもとに構成しています。
検証協力
今回のベンチマーク検証は、合同会社MetAI 様にご協力いただきました。
MetAIは、生成AI・メタバース・AIコンテンツ制作を中心に、企業向けAI活用支援や教育プログラムなどを展開する企業です。
AI画像・動画生成、AIコンテンツ制作、ローカルAI環境活用など、実運用に基づく知見をもとに、今回の検証を実施いただきました。
なお、本取り組みは、株式会社アスク様のご紹介を通じて実現しました。
GeForce RTX 5090を2基搭載できる
液冷GPUワークステーション「AquSys」
今回のベンチマークで使用したGeForce RTX 5090×2のGPU環境は、GDEPソリューションズの液冷GPUワークステーション「AquSys」で構築しています。
高性能GPUを液冷化することで、発熱や騒音を抑えながら、オフィスや研究室で快適にGPUを活用できます。
▶ AquSysの詳細はこちら